Déterministe ou non déterministe : trouver le bon équilibre
Quand laisser un modèle explorer, quand écrire du code, et comment glisser de l'un vers l'autre à mesure qu'on comprend le sujet...
In this article
In this article
Je voudrais parler de déterminisme et de non déterminisme. Et surtout du bon équilibre entre les deux : quand écrire du code classique, et quand laisser faire un agent.
Je parle ici de systèmes basés sur des agents, qui s'appuient sur des skills, pas d'un produit applicatif au sens d'un service pour des clients. La question est alors : laisser l'agent tout faire tout seul, ou faire en sorte qu'il s'appuie sur du code ou des outils adaptés.
Le déterministe, c'est du code écrit pour que la même question donne toujours la même réponse. Pour l'écrire, il faut avoir compris le problème. Et il faut que ce problème s'écrive en règles.
Le non déterministe, c'est le modèle de langage, et l'agent qu'on construit autour. On lui donne un objectif, il choisit son chemin. Et il ne répond pas forcément deux fois de la même façon. Il sert là où le code ne peut pas aller : quand on n'a pas encore compris, ou quand le sujet ne s'écrit pas en règles.
La ligne de partage
Je suis Y Combinator depuis des années. J'avais suivi en ligne How to Start a Startup, le cours que YC a donné à Stanford en 2014, avec des intervenants comme Peter Thiel, Marc Andreessen ou Reid Hoffman. Depuis, je regarde beaucoup ce que fait YC.
Garry Tan, aujourd'hui président de YC, a écrit sur le sujet dans Thin Harness, Fat Skills, le texte qui accompagne son talk du printemps 2026. Il sépare les deux mondes :
Latent space is where intelligence lives. The model reads, interprets, decides. Judgment. Synthesis. Pattern recognition.
Deterministic is where trust lives. Same input, same output. Every time. SQL. Code. Numbers.
(Le modèle, c'est là que vit l'intelligence : il lit, interprète, décide. Le déterministe, c'est là que vit la confiance : même entrée, même sortie, à chaque fois.)
Et il donne un exemple très parlant :
An LLM can seat 8 people at a dinner table. Ask it to seat 800 and it will hallucinate a seating chart that looks plausible but is completely wrong. That's a deterministic problem forced into latent space. The worst systems put the wrong work on the wrong side.
(Un LLM sait placer 8 personnes autour d'une table. Demandez-lui d'en placer 800, il inventera un plan de table plausible mais complètement faux. C'est un problème déterministe confié au modèle. Les pires systèmes mettent le travail du mauvais côté.)
Du coup, j'ai fait une recherche pour voir si d'autres disaient la même chose. Voici ce que j'ai trouvé.
Dex Horthy a discuté avec plus d'une centaine de fondateurs qui veulent rendre leur logiciel plus « agentique ». Dans 12-Factor Agents, il constate que la plupart des produits vendus comme des agents sont « mostly deterministic code, with LLM steps sprinkled in at just the right points » (surtout du code classique, avec un peu de LLM aux bons endroits).
OpenAI va dans le même sens dans son guide pour construire des agents. Pour eux, un agent se justifie quand les décisions sont subtiles, quand les règles deviennent ingérables, ou quand les données ne sont pas structurées. Sinon : « Otherwise, a deterministic solution may suffice. » (sinon, une solution déterministe peut suffire)
Le coût
Ça m'arrive souvent : je fais une demande simple, et je vois le compteur de tokens monter dans mon terminal. Les tokens cramés pour rien s'accumulent. Et ces tokens, ce n'est pas forcément que de l'argent, ce sont aussi des watts.
Le code, lui, coûte beaucoup moins cher à faire tourner. Anthropic le reconnaît dans Building effective agents : les agents « often trade latency and cost for better task performance » (gagnent en qualité, mais au prix de la lenteur et du coût). Leur conseil : « finding the simplest solution possible, and only increasing complexity when needed » (chercher la solution la plus simple, et n'ajouter de la complexité que si c'est nécessaire).
Ils donnent même un chiffre dans Code execution with MCP. Même tâche, deux façons de faire. Dans la première, l'agent fait tout passer par le modèle. Dans la seconde, il écrit un petit bout de code qui fait le travail.
This reduces the token usage from 150,000 tokens to 2,000 tokens—a time and cost saving of 98.7%.
(On passe de 150 000 à 2 000 tokens, soit 98,7 % de temps et de coût en moins.)
Le code aussi a un coût : il faut le développer et le maintenir.
Explorer, puis basculer
Le non déterministe nous permet d'aller plus loin sur un sujet qu'on ne maîtrise pas. On ne sait pas encore quelles règles écrire. Alors on laisse l'agent chercher, se tromper, recommencer.
Mais petit à petit, on commence à voir la programmatique du sujet. L'agent refait les mêmes choses, dans le même ordre. C'est le moment d'introduire du déterministe. Ce qui se répète passe en code. Ce qui change d'une fois sur l'autre reste à l'agent.
On y gagne deux fois. Le code ne consomme plus de tokens à chaque passage. Et quand il se trompe, on peut reproduire l'erreur : même entrée, même erreur. On la retrouve, on la corrige, et un test l'empêche de revenir.
Le non déterministe peut créer du déterministe, pourquoi s'en priver ? À une condition : tester ce code, sinon on fige une erreur.
Garry Tan applique cette idée à son propre agent. Il lui a donné cette consigne :
You are not allowed to do one-off work. If I ask you to do something and it's the kind of thing that will need to happen again, you must: do it manually the first time on 3 to 10 items. Show me the output. If I approve, codify it into a skill file. If it should run automatically, put it on a cron.
(Tu n'as pas le droit de faire du travail jetable. Si je te demande quelque chose qui reviendra, tu le fais d'abord sur 3 à 10 cas et tu me montres le résultat. Si j'approuve, tu l'écris dans une skill. Si ça doit tourner tout seul, tu le planifies.)
Une skill, c'est une fiche d'instructions que l'agent relit la prochaine fois. Ça reste du texte, que le modèle lit et interprète. Mais Garry Tan va plus loin. Dans l'une de ses skills, il demande de sortir en code tout ce qui n'a qu'une seule bonne réponse. Son exemple : un agent se trompait sur le jour de la semaine, parce qu'il le calculait « de tête ». Au lieu de lui réexpliquer, on a mis le calcul dans du code, avec un test. Et on a ajouté une règle :
NEVER derive day-of-week from LLM reasoning
(Ne jamais laisser le LLM déduire le jour de la semaine.)
Avec le temps, la part de code augmente. Par exemple, au début, un système fait 90 % d'agent et 10 % de code. Six mois plus tard, 70 % d'agent et 30 % de code. Et ainsi de suite. Mais la part de l'agent ne tombe jamais à zéro, parce que ce qui ne s'écrit pas en règles reste chez lui. Et quand on ajoute un nouveau sujet, il repart chez l'agent, le temps de l'explorer.
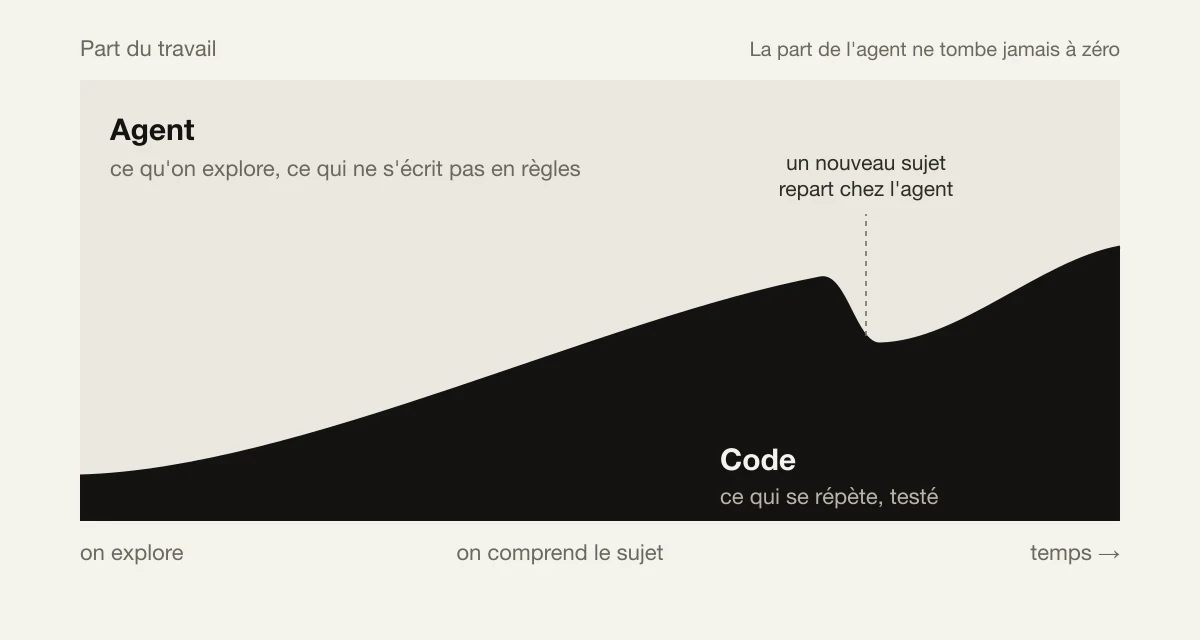
L'équilibre n'est donc pas figé. Il bouge à mesure qu'on comprend le sujet.
On pourrait aller plus loin. Chez Garry Tan, c'est encore un humain qui décide de ce qui passe en code. Et si c'était l'agent ? Il repérerait ce qu'il refait à l'identique, l'écrirait en code et le testerait. Le code répondrait d'abord, et l'agent ne serait appelé que pour les cas nouveaux. Quelqu'un a déjà construit ça ?